讯飞语音大模型新预览上线:不靠转写、直接听懂声音,适合谁关注
科大讯飞推出基于全国产算力训练的语音基座大模型Spark-Audio-1.0-Preview,首次实现模型直接理解音频而非逐字转写。对于数码音频设备开发者、AI语音应用厂商和重度语音交互用户,这是值得关注的新动向;对普通消费者暂无直接购买意义。
非常在线9月16日消息,科大讯飞今日宣布Spark-Audio-1.0-Preview上线,这是一款基于全国产化算力训练的语音基座大模型。与以往先把语音转成文字再交给大模型处理的做法不同,该模型直接对声音本身进行理解,能一次性听懂人声、环境音、音乐等,并捕捉其中的语气、情绪与场景信息。
***: 事实核要
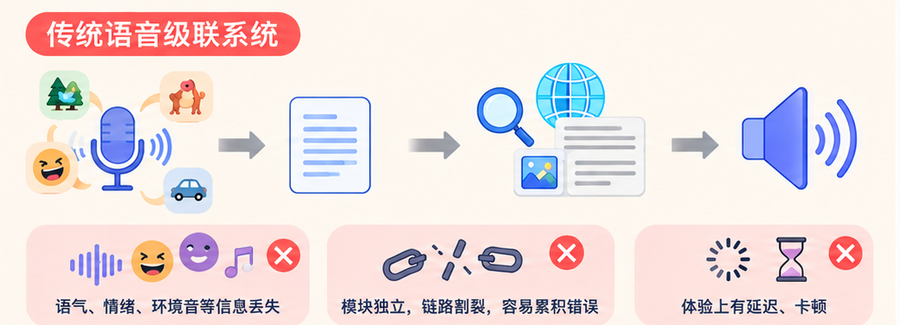
这里有几个关键数字值得留意:模型采用0.65B(Dense结构)音频编码器,搭配30B-A3B(MoE结构)的大语言模型,训练数据包含1300万小时音频和大量文本数据。在过去,语音转写、声纹识别、语音翻译等能力被拆成独立模块串联运行,模块间易累积错误、体验易卡顿;新方案则调整为同一模型内同时输入文本和语音两个模态,号称让机器从“听清”走向“听懂”。
***: 参数与价格
官方暂未公布Spark-Audio-1.0-Preview的具体商用价格,也未开放个人下载或试用入口。就参数而言,它并非直接面向消费者发售的硬件,而是底层技术能力——后续很可能作为云端API或开发者工具包提供。目前普通用户无需为此额外付费,本阶段更像是技术商的实力展示而非消费级商品。
***: 适合谁 / 不适合谁
如果你做智能音箱、语音助手、电话客服系统的产品方案选型,或是数码音频公司的算法工程师,这个新模型显然值得跟踪——它解决了老方案丢语气、丢环境声的先天短板,尤其在嘈杂场景或多方言识别上可能带来体验跳跃。对于只听歌、用智能设备的一般消费者,当前阶段没有任何购买或升级必要,听懂与否最终要看搭载该能力的终端何时落地、调的如何。
***: 同类对比或替代选择
目前市面上的智能语音方案大多仍走“转写-理解”级联路线,这类产品的参数不对外裸奔,但体验示范区主要靠降噪麦克阵列加云端大模型后端。与数据量、推理效果直接挂钩的闭源方案相比,讯飞这次的全国产化算力身份有一定稀缺性——意味着在某些对数据安全敏感的场景(比如政务、国企采购)里有优先采用的可能。但没有纵向对比显示它一定优于海外闭源付费方案,尤其是噪音鲁棒性与多语种覆盖度仍需实际测试验证。
***: 购买/使用建议与避坑提醒
计划跟进本模型的开发者应在申请API前先拿着自己场景里的噪音音频(地铁、街边、多人会议录音)做内部小批量比对测试,不要只信宣传demo。而普通数码爱好者最该关注的是后续哪个品牌把该能力内置进耳机、录音笔、车载语音之中——做不做功能、价格加多少才是购买信号。特别提醒一点,0.65B编码器配合30B主模型对端侧设备算力要求不低,短期内该能力很可能以云端付费调用为主,若宣传智能设备“支持懂了”,便宜得太反常,多半是阉割子集或假持久在线。
***: 尤记避坑点
对消费者最实用的避坑逻辑是:最近两年凡是语音设备吹“上下文理解”的,购买前一律问清离线可用性。当前大模型语音必然依赖网络,断网几乎沦为残废。这类新架构模型的成熟度要打对折看待,常规做法是等首批B端装机使用半年后,再评估值不值得为此多花银子。