智谱MaaS上线数据不留存功能,企业开发者该不该用?
智谱MaaS平台宣布将上线数据不留存机制,用户可申请开通,旨在提供更严格的数据隐私保护。但Batch API等场景及法律要求的数据仍会留存。对于注重代码安全和数据隐私的企业与开发者,这是一项值得关注的合规升级,但需明确其适用范围。
非常在线9月21日消息,智谱MaaS平台于今日宣布,将于近期上线数据内容不留存功能,为企业和开发者用户提供更严格的数据隐私保护。该机制的推出,意味着用户在申请并通过审核后,其模型调用过程中的输入和输出内容将不会在平台侧进行静态存储,数据仅用于完成当次模型调用。此前,智谱因旗下编程产品ZCode的“代码库索引”功能被质疑存在数据上传问题,并于9月18日向受影响用户致歉,官方称问题已修复。此次MaaS平台的新动作,被视为是对数据安全关切的一轮直接回应。
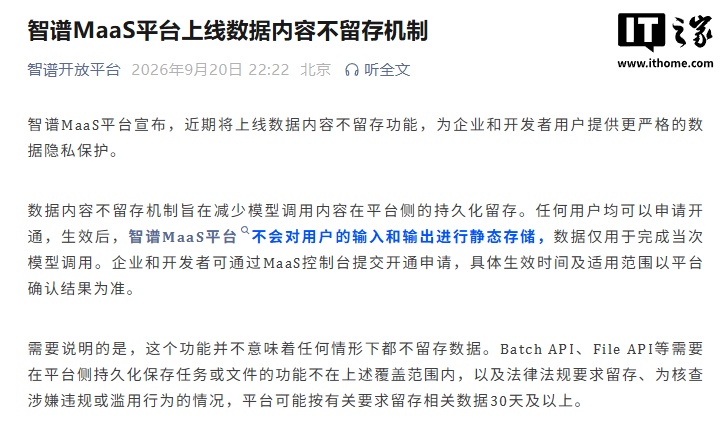
据官方公告,数据内容不留存机制目前阶段并非完全绝对。任何用户均可通过MaaS控制台提交开通申请,具体生效时间及适用范围需以平台确认结果为准。换句话说,这是一项“申请制”的功能,而非对所有用户默认生效。对于长期依赖云端API调用的开发者和企业而言,这一变化有望降低商业数据在第三方平台的留存风险。
但需要厘清边界的是,官方明确表示,Batch API、File API等需要在平台侧持久化保存任务或文件的功能,并不在该机制的覆盖范围内。同时,因法律法规要求留存,或为核查涉嫌违规、滥用行为的情况,平台仍可能按有关要求留存相关数据30天及以上。这意味着,数据不留存并非“无死角”保护,其实际保障程度取决于用户的使用场景和交互类型。
本次功能上线,最直接的价值在于为中小型开发团队和对知识产权、内部代码保密性有较高要求的企业,提供了一个更合规、更可控的模型调用选项。过去使用MaaS服务时,用户往往难以确认自己发送的提示词和模型输出在结束后是否即刻被清除;不留存功能的落地,在一定程度上回答了这部分疑虑,减少了因“数据外流”引发的信任成本。
不适合哪些用户关注的,则是高频使用文件上传、批量推理或长期对话存档能力的团队。如果你依赖Batch API进行离线大批量处理,或通过File API进行知识库关联,那么本次上线的新机制几乎没有实质影响。因为官方已将这两类场景纳入排除列表。同时,在司法或监管调查等特殊情形下,平台仍有权依规保留一定周期的数据,因此不适用“绝对不留痕”的预期。
关于费用与性能参数,官方在本次公告中并未公布与该功能相关的任何附加价格或服务等级说明。选择启用数据不留存机制,有可能在用户同意书或服务协议层面产生新的条款变化,企业在申请前应向平台方确认是否存在接口调用速率、审核时效或服务成本方面的区别对待。在同类服务层面,目前头部云厂商与国内大模型开放平台普遍提供区域化数据存储、私有化部署或专用VPC隔离方案,但在“不留存”的显式承诺上,各家的SLA管理政策并未完全统一。部分平台提供更细粒度的数据留存偏好设置,而另一部分则仅承诺加密存储。企业在选择时,可将“显式不留存声明”与“本地化部署”并列为两条独立的验收标准。
从实际操作角度看,建议先从官方控制台提交开通申请,完整阅读服务协议与隐私说明中的免责条款,务必确认Batch API与File API路径下是否存在应用交织的实际情况。若核心业务涉及代码库索引或持续按对话上下文的查询扩展,那么应留有时间窗口进行回归测试,避免在关闭数据留存后导致会话恢复、历史版本回退等功能不可用。
对于重点关注AI研发成本与产出安全的决策者而言,本次MaaS数据不留存机制更适合视为一项隐私保障的“加分项”,而非采购决策中的决定性唯一参数。此前ZCode的问题提醒行业,真正的数据安全不只是上传环节的轻信与自我的背书,还包括代码管理、开发习惯和第三方审计机制。在多元化模型齐上阵的时代,每一层数据传输用以形成的能力积累,都是交给平台的信任切片。明确界限方能有利取舍。无论政策何时全面生效,主动了解、提前申请、保持关注,依旧是避免数据风险最务实的三条路径。